Gemini 模型终于推出新一代旗舰版本 Gemini 4 Argon。单次输出上限由6.4万 Token跳升至100万,官方在19项测试中列出13项独占第一,但普通用户目前尚无试用入口。
重點速覽
- Argon 单次最多可输出 100 万 Token,这并不等于可一次性输入同等数量内容。
- Google 给出的比较显示,Argon 在19项测试中有13项独占第一、1项并列第一;其余项目未能全胜。
- Google 尚未公布普通用户的开放时间,要亲自比较 Argon 与平日使用的 Gemini 差异,还需等待更广泛的可用性。
Gemini 模型:百万 Token,不是百万字
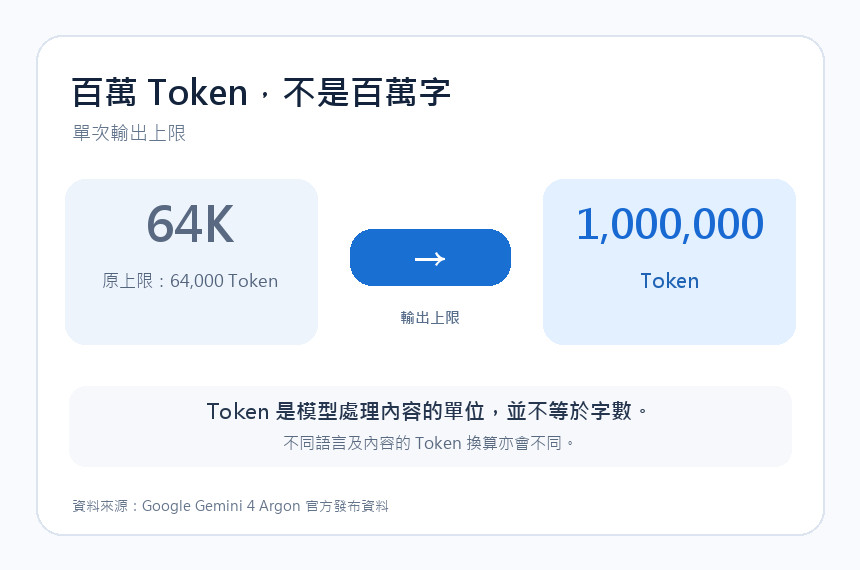
Argon 最抢眼的规格是单次输出上限从6.4万 Token提升到100万。Token是模型处理内容的基本单位,不等同于字数;100万 Token 并不意味着可以立刻生成一本长篇小说。
Google 给出的示例偏向实际工作场景:内部团队用 Argon 协助处理大型程序修改,网络安全公司 Wiz 在项目中使用该模型,且在一款医疗软件中发现可能泄露敏感个人资料的漏洞。这些案例显示 Argon 目标任务,但无法证明它在写邮件或安排行程时也会带来同等提升。
13 项第一,还有 5 项未赢
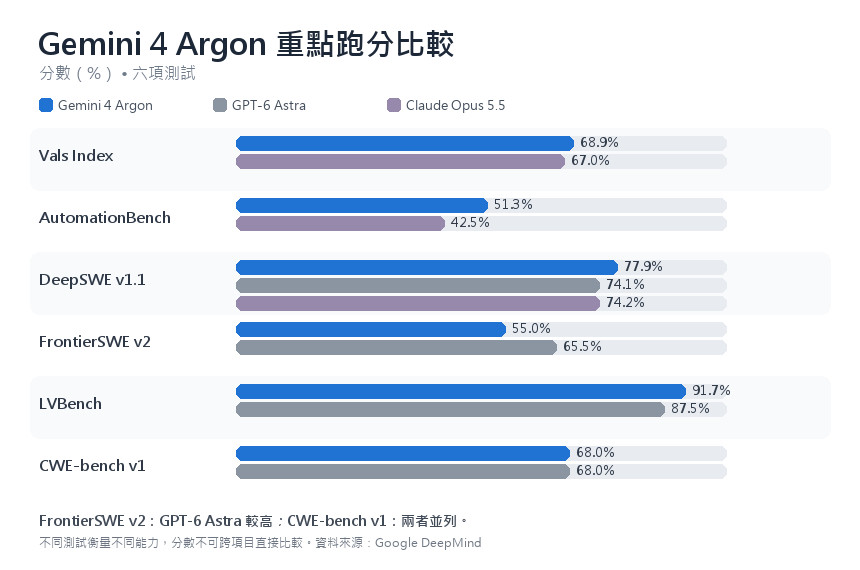
根据 Google DeepMind 的成绩表,Argon 在长期软件开发测试 DeepSWE v1.1 得分77.9%,高于 GPT-6 Astra 的74.1%与 Claude Opus 5.5 的74.2%。但在另一项 FrontierSWE v2 测试,Argon 得分55.0%,低于 GPT-6 Astra 的65.5%。
需要注意的是,Google 在测试说明中写明,部分 Argon 成绩由公司自行计算,其他模型的数据则取自公开排行榜或供应商资料,并非全部在相同条件下重测。独立评测机构 Artificial Analysis 给出 Argon 与 GPT-6 Astra 相同的综合指数得分53分,同时指出 Argon 在其 Terminal Bench 4 测试落后数款对手。
几时轮到普通用户?
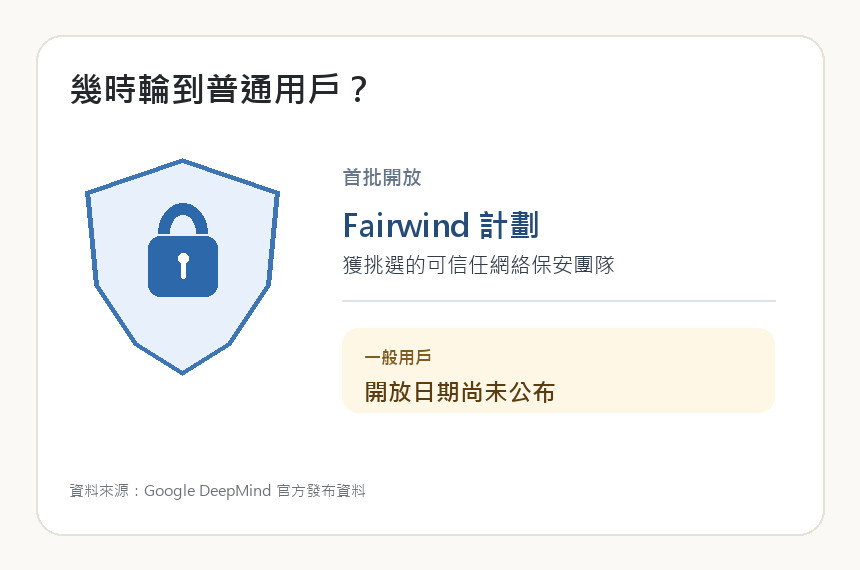
目前 Argon 优先交由 Fairwind 计划下的受邀网络安全团队使用。Google 表示,后续会逐步扩展到付费 API 客户与 Google AI Ultra 订阅者,但未公布普通用户确切开放日期。
Google 已列出 API 推出初期定价:每百万输入 Token 为 2 美元,每百万输出 Token 为 10 美元;优惠期后分别为 4 美元及 20 美元,Google 未交代优惠期结束时间。按既定汇率换算,每百万输入 Token 约合人民币13.43元(原价2美元),每百万输出 Token 约合人民币67.17元(原价10美元);优惠期后分别约合人民币26.87元与134.34元(原价4美元与20美元)。
Google 官方 19 项跑分比较与说明
以下依据 Google DeepMind 官方图表整理资料。表中绿色底色代表该项表格中的最高分,不代表仅限 Argon 获此标示;未列出则表示官方没有提供该模型的数字。
| 範疇 | 測試項目 | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|---|
| 專業工作 | Vals Index | 68.9% | 63.1% | 65.8% | 67.0% |
| 專業工作 | AutomationBench(分數) | 51.3% | 41.4% | 31.4% | 42.5% |
| 專業工作 | Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% |
| 專業工作 | Harvey’s Legal Agent Benchmark | 19.6% | 5.4% | 6.7% | 3.8% |
| 程式開發 | DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% |
| 程式開發 | FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% |
| 程式開發 | Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% |
| 程式開發 | Terminal-bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% |
| 機器學習工程 | PostTrainBench | 45.3% | 44.3% | 40.2% | 49.3% |
| 科學及數學 | Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% | 63.3% |
| 科學及數學 | LABBench 2 | 88.8% | 85.4% | 68.6% | 73.1% |
| 科學及數學 | RiemannBench | 76.0% | 72.0% | 65.6% | 69.6% |
| 長篇內容理解 | GraphWalks(最多 12.8 萬 Token) | 99.7% | 98.7% | 91.4% | 90.6% |
| 長篇內容理解 | GraphWalks(25.6 萬至 100 萬 Token) | 84.2% | 71.8% | 65.0% | 66.8% |
| 電腦操作 | Agent’s Last Exam(通過率) | 39.5% | 34.2% | 未列出 | 38.2% |
| 電腦操作 | OSWorld-2.0(離線測試部分得分) | 69.2% | 72.6% | 未列出 | 未列出 |
| 圖像及影片理解 | Chartography | 71.6% | 71.0% | 46.2% | 66.3% |
| 圖像及影片理解 | LVBench | 91.7% | 87.5% | 79.7% | 83.7% |
| 網絡保安 | CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% |
注:以上为根据 Google DeepMind 公布的19项比较整理,部分测试由 Google 自行计算,其他模型的成绩亦可能取自公开排行榜或模型供应商。各测试的设置不同,分数不能跨项目直接比较,详见官方测试方法。