Gemini ArgonはGoogleが発表した新世代フラッグシップモデルだ。単回の出力上限が6.4万Tokenから100万Tokenへ大幅に拡張された。
要点
- 出力上限は1回あたり最大100万Tokenだが、これは必ずしも同時に100万Tokenを入力できることを意味しない。
- Googleの比較表では、19項目のうち13項目でArgonが単独トップ、1項目で同率トップだった。ただし全項目で無条件に勝利したわけではない。
- 一般ユーザーがいつ試せるかは未発表。まずは選ばれたネットワークセキュリティチームが利用する段階だ。
Gemini Argonと「百万トークン」の意味
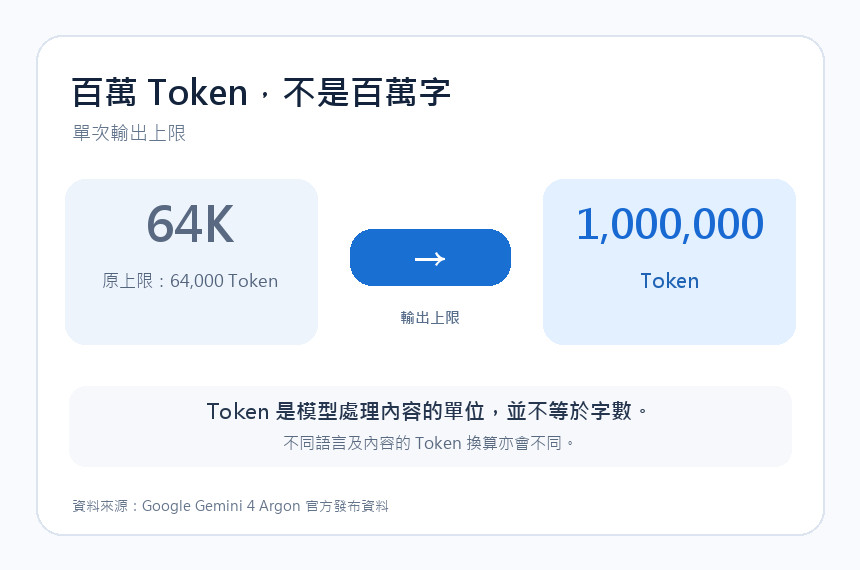
Argonで注目されるのは、単回の出力上限が6.4万Tokenから100万Tokenに増えた点だ。TokenはAIが扱う単位であり、文字数と一対一ではない。
Googleは長時間のコード修正や多段階のリサーチなど、長い生成が必要な業務を想定していると説明している。日常のメール作成や旅行プラン整理で即座に同等の恩恵が得られるかは別問題だ。
実務での想定ユースケース
Googleが示した例は主に業務向けだった。社内チームがArgonで大規模なソフト改修を支援したという。ネットワークセキュリティ企業Wizは同モデルを使い、医療ソフトで個人情報流出の可能性を発見した。
これらの事例はGoogleがArgonに期待する役割を示す。しかし、一般ユーザー向けの利用で同等の改善が得られるかは実地検証が必要だ。
ベンチマーク結果の読み方
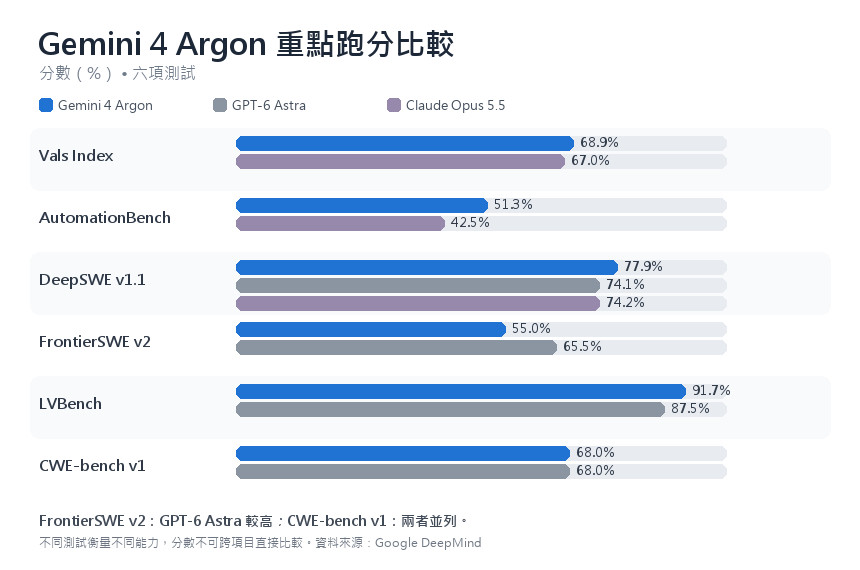
Google DeepMindが公開した成績表では、Argonは長時間ソフトウェア開発テストDeepSWE v1.1で77.9%を記録した。GPT-6 Astraは74.1%、Claude Opus 5.5は74.2%だった。
しかし別のテストFrontierSWE v2ではArgonは55.0%にとどまり、GPT-6 Astraの65.5%に及ばない。テストごとに順位は変わり得る。
またGoogleのテスト方法の説明には、Argon側の一部スコアは自社算出である旨が記されている。ほかのモデルの数字は公開ランキングや供給元の資料に基づく場合があると注記されている。
独立評価のArtificial Analysisは、ArgonとGPT-6 Astraに同じ総合指数53点を与えた。独自のTerminal Bench 4ではArgonが数機種に後れを取ったと報告している。「単独無敵」とは言えない状況だ。
いつ一般ユーザーに開放されるか
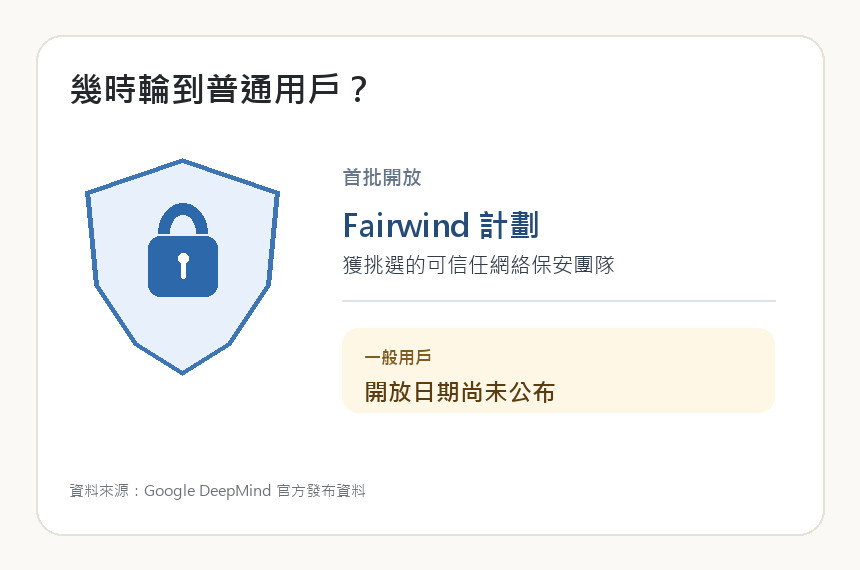
現時点でArgonはFairwindプログラムの信頼できるネットワークセキュリティチームにまず提供されている。Googleは今後、有料API契約者やGoogle AI Ultraの加入者へ段階的に拡大するとしているが、一般公開日程は示していない。
モデルは発表されたが、一般利用者が実際に触れるまでには時間がかかる見込みだ。まずは実地評価が重要である。
API価格と試用条件
GoogleはAPIの初期価格を公表した。入力100万Tokenあたり2米ドルは約315円だ。出力100万Tokenあたり10米ドルは約1,573円である。
プロモーション期間終了後は、入力が100万Tokenあたり4米ドル(約629円)、出力が100万Tokenあたり20米ドル(約3,147円)へ引き上げられる予定だと示されている。プロモーション期間の終了日は未発表だ。
Googleの19項目比較(要旨)
以下はGoogle DeepMindの公式図表に基づく整理だ。緑背景は各項目での最高点を示すものであり、Argon専用のマーキングではない。項目ごとに評価対象が異なるため、得点の単純比較は注意を要する。
| 範疇 | 測試項目 | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|---|
| 專業工作 | Vals Index | 68.9% | 63.1% | 65.8% | 67.0% |
| 專業工作 | AutomationBench(分數) | 51.3% | 41.4% | 31.4% | 42.5% |
| 專業工作 | Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% |
| 專業工作 | Harvey’s Legal Agent Benchmark | 19.6% | 5.4% | 6.7% | 3.8% |
| 程式開發 | DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% |
| 程式開發 | FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% |
| 程式開發 | Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% |
| 程式開發 | Terminal-bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% |
| 機器學習工程 | PostTrainBench | 45.3% | 44.3% | 40.2% | 49.3% |
| 科學及數學 | Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% | 63.3% |
| 科學及數學 | LABBench 2 | 88.8% | 85.4% | 68.6% | 73.1% |
| 科學及數學 | RiemannBench | 76.0% | 72.0% | 65.6% | 69.6% |
| 長篇內容理解 | GraphWalks(最多 12.8 萬 Token) | 99.7% | 98.7% | 91.4% | 90.6% |
| 長篇內容理解 | GraphWalks(25.6 萬至 100 萬 Token) | 84.2% | 71.8% | 65.0% | 66.8% |
| 電腦操作 | Agent’s Last Exam(通過率) | 39.5% | 34.2% | 未列出 | 38.2% |
| 電腦操作 | OSWorld-2.0(離線測試部分得分) | 69.2% | 72.6% | 未列出 | 未列出 |
| 圖像及影片理解 | Chartography | 71.6% | 71.0% | 46.2% | 66.3% |
| 圖像及影片理解 | LVBench | 91.7% | 87.5% | 79.7% | 83.7% |
| 網絡保安 | CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% |
注:以上はGoogle DeepMindが公表した19項目の比較を基に整理した。部分的にArgonのスコアはGoogle側算出である点、他モデルの数値は公開ランキングや供給元資料に基づく場合がある点に留意されたい。詳細は公式のテスト方法を参照されたい。

