Gemini 模型的最新旗艦 Gemini 4 Argon 正式亮相,Google 宣稱單次輸出上限從 6.4萬 Token 提升至 100萬 Token,並在官方成績表的 19 項測試中,有 13 項獨占第一。
Gemini 模型重點速覽
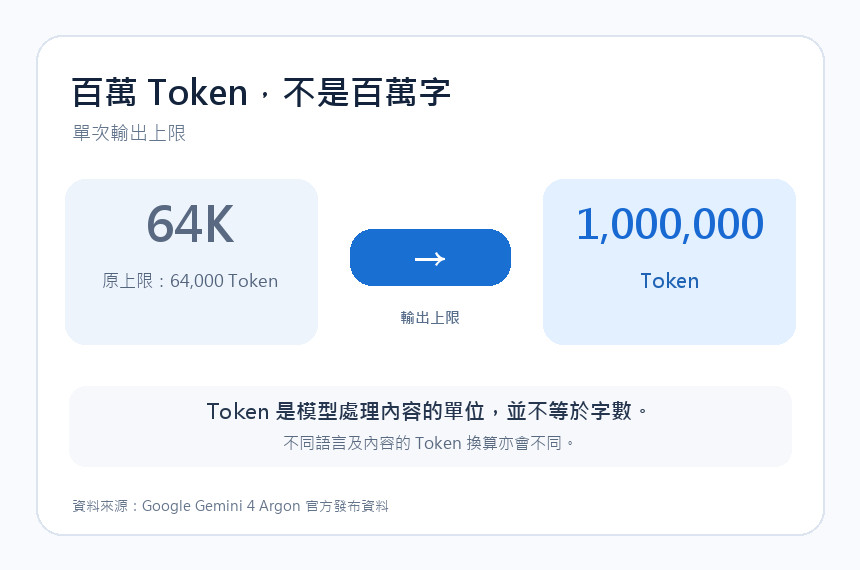
- Argon 單次最多可輸出 100萬 Token,這指的是輸出上限,不等同於單次可輸入或每次只回覆一句話即可產生長篇小說。
- Google 在 19 項比較中列出 Argon 有 13 項獨占第一、1 項並列第一,其餘項目則由不同模型領先。
- 目前只有受邀的可信任網絡保安團隊能先行使用,Google 尚未公布一般用戶何時可試用,需等待後續擴展計劃。
百萬 Token,實際意義與適用場景
Google 說明,Token 是模型處理文字與程式碼的內部單位,並不等同於字數,實務上更適合形容能一次生成或串接的內容長度。
這次 Argon 把輸出上限從 6.4萬 Token 拉高到 100萬 Token,目的在支援大型程式碼修改、跨步驟研究與長時間生成等工作,而非單純改善一般日常問答體驗。
Google 舉出的案例偏向企業內部或研究單位使用,例如內部團隊讓 Argon 協助處理大型程式、網路安全廠商利用模型檢測軟體漏洞,並找到可能洩露敏感個資的情況。
跑分成績與局限性
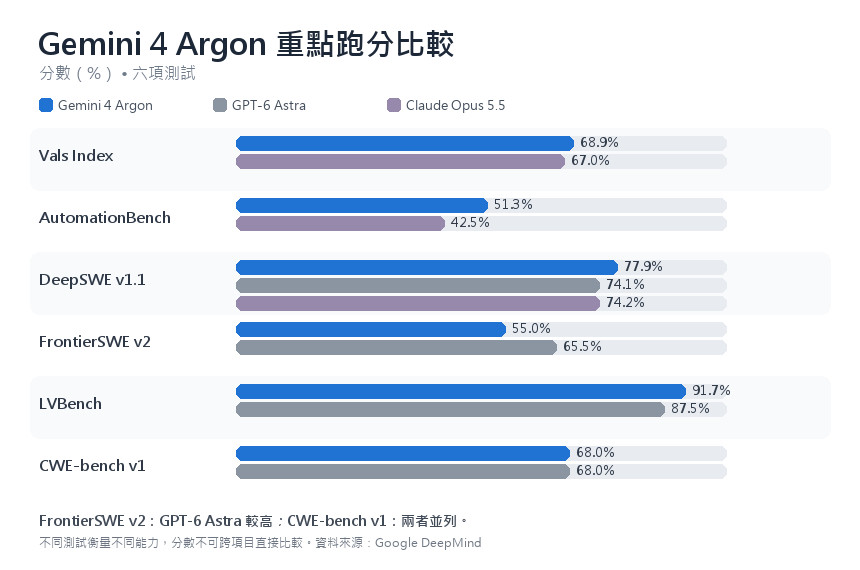
在 Google DeepMind 公布的成績表中,Argon 在長時間軟體開發測試 DeepSWE v1.1 得分 77.9%,高於 GPT-6 Astra 的 74.1% 與 Claude Opus 5.5 的 74.2%。
不過,換到 FrontierSWE v2 測試,Argon 得分 55.0%,低於 GPT-6 Astra 的 65.5%,顯示不同題組或場景下,名次會有變動,跑分不能一概而論。
此外,Google 在方法說明指出,部分 Argon 成績由公司自行計算,其他模型數據則取自公開排行榜或供應商資料,並非所有模型都在相同條件下重新測試。
獨立評測機構 Artificial Analysis 給予 Argon 與 GPT-6 Astra 相同的綜合指數分數 53 分,並指出 Argon 在其 Terminal Bench 4 測試落後數款對手,顯示「有力一戰」,但尚不足以宣稱全面領先。
何時輪到一般用戶使用 Gemini 模型 Argon?
目前 Argon 先在 Google 的 Fairwind 計劃下,向受挑選的可信任網路保安團隊開放使用,Google 表示將逐步擴展至付費 API 客戶與 Google AI Ultra 訂閱者,但尚未公布一般用戶的確切開放日期。
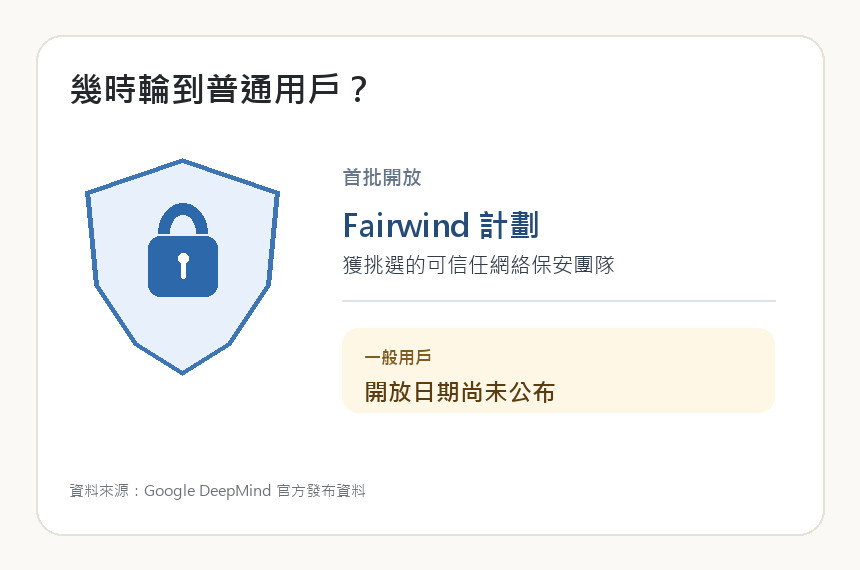
換言之,模型已公布性能與定價細節,但多數用戶暫時仍無法直接體驗 Argon 的實際表現,只能透過官方跑分或第三方評測了解差異。
API 價格換算與使用成本
Google 在公布時列出 API 推出初期價格,原文為每百萬輸入 Token 2 美元、每百萬輸出 Token 10 美元;優惠期後分別為 4 美元及 20 美元。
依照本文採用的換算匯率 1 美元=31.901 新台幣,初期價格換算後為每百萬輸入 Token 約新台幣 64 元(原價 2 美元),每百萬輸出 Token 約新台幣 319 元(原價 10 美元)。
優惠期結束後,價格分別約為每百萬輸入 Token 新台幣 128 元(原價 4 美元),每百萬輸出 Token 約新台幣 638 元(原價 20 美元),Google 未說明優惠期何時結束。
官方比較表摘要與說明
以下整理自 Google DeepMind 官方圖表,表中綠底代表該項目最高分,但該顏色並非表示 Argon 專屬,分數也不應跨項目直接比較。
| 範疇 | 測試項目 | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|---|
| 專業工作 | Vals Index | 68.9% | 63.1% | 65.8% | 67.0% |
| 專業工作 | AutomationBench(分數) | 51.3% | 41.4% | 31.4% | 42.5% |
| 專業工作 | Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% |
| 專業工作 | Harvey’s Legal Agent Benchmark | 19.6% | 5.4% | 6.7% | 3.8% |
| 程式開發 | DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% |
| 程式開發 | FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% |
| 程式開發 | Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% |
| 程式開發 | Terminal-bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% |
| 機器學習工程 | PostTrainBench | 45.3% | 44.3% | 40.2% | 49.3% |
| 科學及數學 | Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% | 63.3% |
| 科學及數學 | LABBench 2 | 88.8% | 85.4% | 68.6% | 73.1% |
| 科學及數學 | RiemannBench | 76.0% | 72.0% | 65.6% | 69.6% |
| 長篇內容理解 | GraphWalks(最多 12.8 萬 Token) | 99.7% | 98.7% | 91.4% | 90.6% |
| 長篇內容理解 | GraphWalks(25.6 萬至 100 萬 Token) | 84.2% | 71.8% | 65.0% | 66.8% |
| 電腦操作 | Agent’s Last Exam(通過率) | 39.5% | 34.2% | 未列出 | 38.2% |
| 電腦操作 | OSWorld-2.0(離線測試部分得分) | 69.2% | 72.6% | 未列出 | 未列出 |
| 圖像及影片理解 | Chartography | 71.6% | 71.0% | 46.2% | 66.3% |
| 圖像及影片理解 | LVBench | 91.7% | 87.5% | 79.7% | 83.7% |
| 網絡保安 | CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% |
註:以上依據 Google DeepMind 公布的 19 項比較整理,部分測試由 Google 自行計算,其他模型成績可能取自公開排行榜或模型供應商。各項測試的設定不同,詳見官方測試方法。