Google 終於端出新一代旗艦模型 Gemini 4 Argon。單次輸出上限由 6.4 萬 Token 跳至 100 萬,官方成績表上亦有 19 項測試中的 13 項獨佔第一。聽起來很想立即打開 Gemini 試試?先等等。首批能用到 Argon 的,是獲挑選的網絡保安團隊,一般用戶目前連試用入口也未有。
重點速覽
- Argon 單次最多可輸出 100 萬 Token,並非指一次可以輸入這麼多內容。
- Google 公布的比較中,Argon 於 19 項測試有 13 項獨佔第一、1 項並列第一;其餘項目並非全勝。
- Google 未公布一般用戶何時可用。暫時要比較 Argon 與自己平日用的 Gemini 有多大分別,還得靠成績表,不能靠親手試。
百萬 Token,不是百萬字
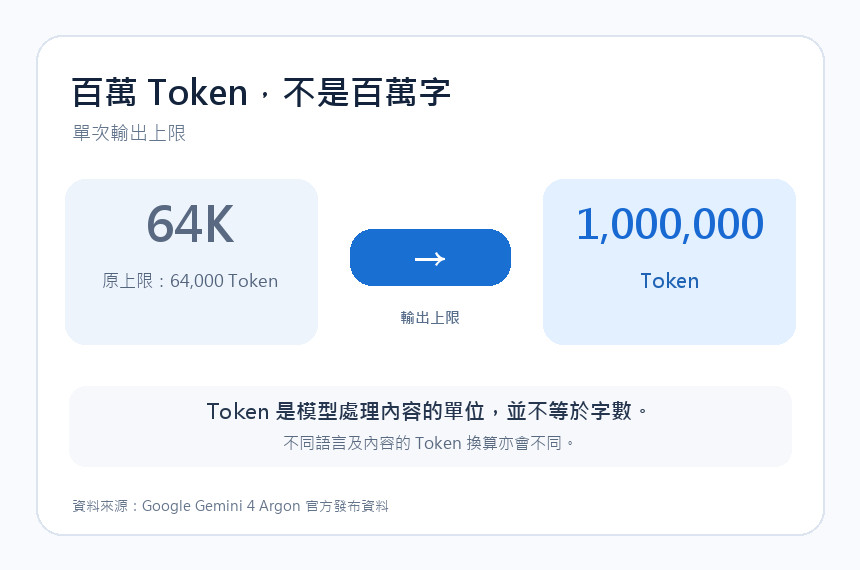
Argon 最搶眼的規格,是單次輸出上限從 6.4 萬 Token 增至 100 萬。Token 是 AI 處理內容的單位,不直接等於字數;「輸出上限」亦不等於每次問它一句話,它就會交來一本長篇小說。Google 着眼的是大型程式修改、多步驟研究等需要長時間生成內容的工作。
Google 公布的例子也相當「返工味」:內部團隊用 Argon 協助處理大型程式,網絡保安公司 Wiz 則透過相關計劃使用模型,並在一套醫療軟件中發現可能洩露敏感個人資料的漏洞。這些案例說明 Google 想讓 Argon 處理甚麼任務,但未能證明它替普通人寫電郵、整理旅行行程時,也會有同樣明顯的進步。
13 項第一,還有 5 項未贏
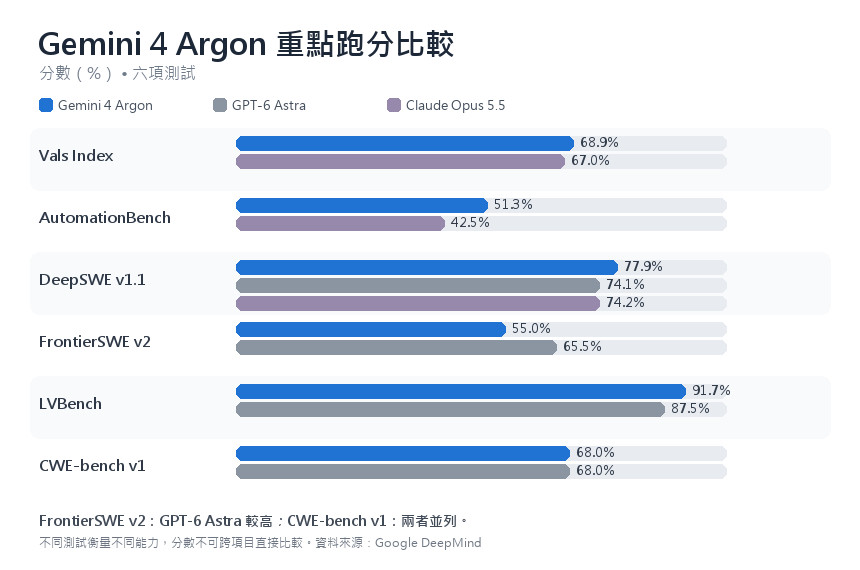
按 Google DeepMind 的成績表,Argon 在長時間軟件開發測試 DeepSWE v1.1 得分 77.9%,高於 GPT-6 Astra 的 74.1% 和 Claude Opus 5.5 的 74.2%。不過,換到另一項軟件工程測試 FrontierSWE v2,Argon 得分 55.0%,低於 GPT-6 Astra 的 65.5%。同樣考寫程式,換一份考卷,名次就可以不同。
這份排行榜還有一個容易被標題擠走的細節:Google 的測試說明指出,部分 Argon 成績由公司自行計算,其他模型的數字則因應項目取自公開排行榜或供應商資料,並非全部在同一條件下重新測試。獨立評測機構 Artificial Analysis 給 Argon 和 GPT-6 Astra 相同的綜合指數得分 53 分,同時指出 Argon 在其 Terminal Bench 4 測試落後數款對手。「有力一戰」有數據支持;「打遍天下無敵手」就說得太早。
幾時輪到普通用戶?
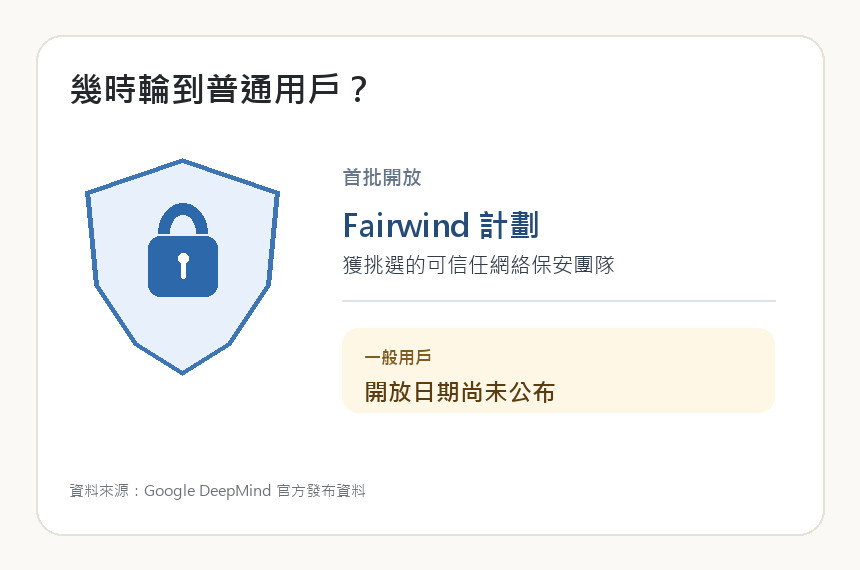
目前 Argon 先交由 Fairwind 計劃下的可信任網絡保安團隊使用。Google 表示,之後會逐步擴展至付費 API 客戶及 Google AI Ultra 訂閱者,但尚未公布一般用戶的確實開放日期。換言之,模型已經發表,普通用戶的「立即試用」按鈕仍未出場。
Google 已列出 API 推出初期價格:每百萬輸入 Token 2 美元、每百萬輸出 Token 10 美元;優惠期後分別為 4 美元及 20 美元,惟未交代優惠期何時結束。價錢表先到,使用資格稍後才到,現階段最值得留意的仍是 Google 何時讓更多人實際測試 Argon,而不是單靠跑分替它頒獎。
Google 官方 19 項跑分比較
以下按 Google DeepMind 官方圖表整理。綠底代表該項目表中最高分,不是 Argon 專用標記;「未列出」表示官方表格沒有提供該模型的數字。各項測試衡量的能力不同,分數亦不能跨項目直接比較。
| 範疇 | 測試項目 | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|---|
| 專業工作 | Vals Index | 68.9% | 63.1% | 65.8% | 67.0% |
| 專業工作 | AutomationBench(分數) | 51.3% | 41.4% | 31.4% | 42.5% |
| 專業工作 | Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% |
| 專業工作 | Harvey’s Legal Agent Benchmark | 19.6% | 5.4% | 6.7% | 3.8% |
| 程式開發 | DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% |
| 程式開發 | FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% |
| 程式開發 | Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% |
| 程式開發 | Terminal-bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% |
| 機器學習工程 | PostTrainBench | 45.3% | 44.3% | 40.2% | 49.3% |
| 科學及數學 | Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% | 63.3% |
| 科學及數學 | LABBench 2 | 88.8% | 85.4% | 68.6% | 73.1% |
| 科學及數學 | RiemannBench | 76.0% | 72.0% | 65.6% | 69.6% |
| 長篇內容理解 | GraphWalks(最多 12.8 萬 Token) | 99.7% | 98.7% | 91.4% | 90.6% |
| 長篇內容理解 | GraphWalks(25.6 萬至 100 萬 Token) | 84.2% | 71.8% | 65.0% | 66.8% |
| 電腦操作 | Agent’s Last Exam(通過率) | 39.5% | 34.2% | 未列出 | 38.2% |
| 電腦操作 | OSWorld-2.0(離線測試部分得分) | 69.2% | 72.6% | 未列出 | 未列出 |
| 圖像及影片理解 | Chartography | 71.6% | 71.0% | 46.2% | 66.3% |
| 圖像及影片理解 | LVBench | 91.7% | 87.5% | 79.7% | 83.7% |
| 網絡保安 | CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% |
註:以上按 Google DeepMind 公布的 19 項比較整理;部分測試由 Google 自行計算,其他模型的成績亦可能取自公開排行榜或模型供應商。個別項目的測試設定不同,詳見官方測試方法。