Google ในที่สุดก็เปิดตัวโมเดลเรือธงรุ่นใหม่ Gemini 4 Argon โดยจุดเด่นคือขีดจำกัดการส่งออกครั้งเดียวเพิ่มจาก 64,000 Token เป็น 1,000,000 Token ตามตารางคะแนนอย่างเป็นทางการ Argon ครองอันดับหนึ่งแบบเฉพาะตัวใน 13 จาก 19 การทดสอบ แต่ถ้าคิดจะลองใช้ทันทีต้องรอก่อน — รอบแรกที่ได้ใช้คือทีมความปลอดภัยไซเบอร์ที่ได้รับคัดเลือก ผู้ใช้ทั่วไปยังไม่มีช่องทางทดลอง
สรุปประเด็นสำคัญ
- Argon ในการรันครั้งเดียวสามารถส่งออกได้สูงสุด 1,000,000 Token แต่ไม่ได้หมายความว่าจะรับข้อความเข้าได้เท่ากันในหนึ่งครั้ง
- จากการเปรียบเทียบที่ Google เปิดเผย Argon ครองอันดับหนึ่งใน 13 จาก 19 การทดสอบ และมี 1 รายการที่ได้อันดับหนึ่งร่วม; ไม่ได้หมายความว่าจะชนะทุกรายการ
- Google ยังไม่แจ้งวันเปิดให้ผู้ใช้ทั่วไปทดลอง ดังนั้นการเปรียบเทียบ Argon กับ Gemini ที่ใช้อยู่ประจำต้องอาศัยตารางคะแนน ไม่ใช่การใช้งานจริงของผู้ใช้ทั่วไป
หนึ่งล้าน Token ไม่ใช่ล้านคำ
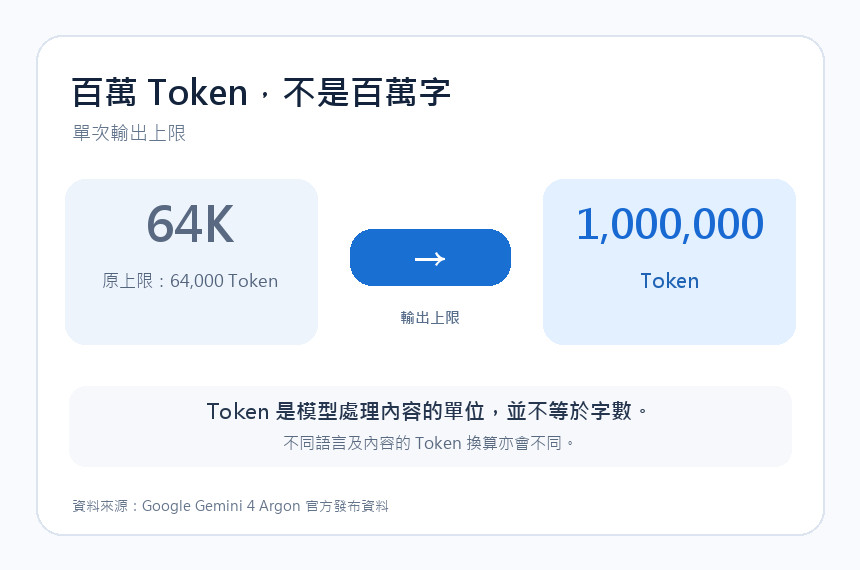
สเปกระดับที่สะดุดตาของ Argon คือขีดจำกัดการส่งออกต่อครั้งที่เพิ่มจาก 64,000 Token มาเป็น 1,000,000 Token ซึ่ง Token เป็นหน่วยการประมวลผลของโมเดล ไม่ได้เทียบเท่ากับจำนวนคำโดยตรง และการมี “ขีดจำกัดการส่งออก” ไม่ได้หมายความว่าถ้าถามครั้งเดียวจะได้หนังสือเล่มยาวทันที จุดประสงค์ที่ Google เน้นคือการรองรับงานขนาดใหญ่ เช่น การปรับแก้ซอฟต์แวร์ขนาดใหญ่หรือการทำงานวิจัยหลายขั้นตอน ที่ต้องการการสร้างเนื้อหาต่อเนื่องเป็นเวลานาน
ตัวอย่างที่ Google ยกมาให้เห็นภาพค่อนข้างเป็นงานเชิงองค์กร: ทีมภายในใช้ Argon ช่วยจัดการโค้ดขนาดใหญ่ บริษัทความปลอดภัยไซเบอร์ Wiz ที่เข้าร่วมโครงการก็ใช้โมเดลนี้ตรวจพบช่องโหว่ในซอฟต์แวร์ทางการแพทย์ซึ่งอาจรั่วไหลข้อมูลส่วนบุคคล เหล่านี้ชี้ให้เห็นว่า Google ตั้งใจให้ Argon ทำงานประเภทใด แต่ยังไม่มีหลักฐานยืนยันว่าเมื่อใช้กับงานประจำวันที่ผู้ใช้ทั่วไปทำอย่างเขียนอีเมลหรือจัดทริป จะเห็นความแตกต่างชัดเจนเหมือนงานเชิงองค์กร
ครองอันดับหนึ่ง 13 รายการ แต่ยังมี 5 รายการที่ไม่ชนะ
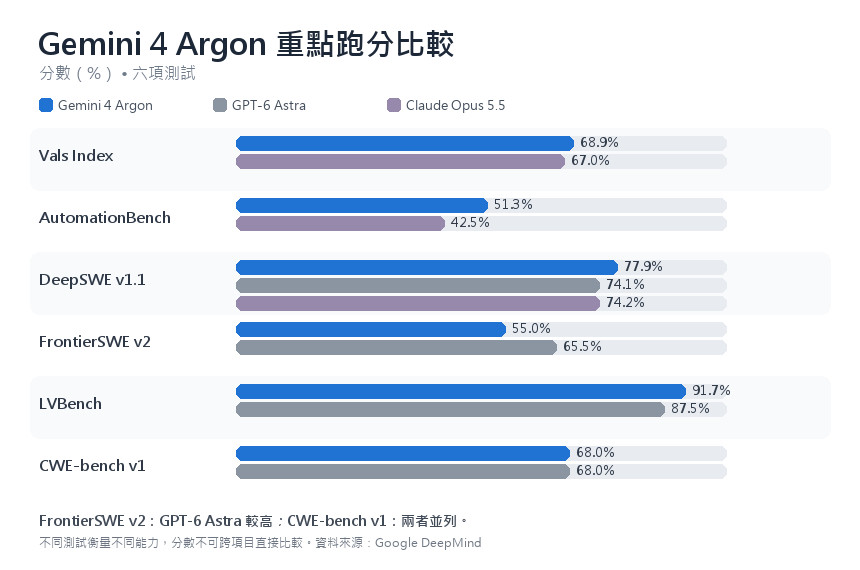
จากตารางคะแนนของ Google DeepMind Argon ทำคะแนนในการทดสอบซอฟต์แวร์ระยะยาว DeepSWE v1.1 ได้ 77.9% สูงกว่า GPT-6 Astra ที่ได้ 74.1% และ Claude Opus 5.5 ที่ได้ 74.2% อย่างไรก็ตาม ในการทดสอบวิศวกรรมซอฟต์แวร์อีกชุด FrontierSWE v2 Argon ได้ 55.0% ต่ำกว่า GPT-6 Astra ที่ได้ 65.5% แสดงให้เห็นว่าผลงานในการทดสอบเขียนโปรแกรมสามารถเปลี่ยนแปลงได้ตามชุดข้อสอบ
รายละเอียดอีกข้อที่มักถูกมองข้ามคือเอกสารคำอธิบายการทดสอบของ Google ระบุว่า ผลคะแนนบางส่วนของ Argon เป็นการคำนวณโดย Google เอง ขณะที่ตัวเลขของโมเดลอื่นๆ อาจมาจากตารางคะแนนสาธารณะหรือข้อมูลจากผู้ให้บริการ ไม่ได้หมายความว่าทุกโมเดลถูกทดสอบใหม่ภายใต้เงื่อนไขเดียวกัน หน่วยทดสอบอิสระอย่าง Artificial Analysis ให้คะแนนรวม Argon และ GPT-6 Astra ที่ดัชนี 53 คะแนน และชี้ว่า Argon ยังตามหลังคู่แข่งบางตัวในการทดสอบ Terminal Bench 4 ดังนั้นการบอกว่าเป็นผู้ชนะแบบไร้เทียมทานอาจเร็วเกินไป
เมื่อไหร่จะถึงคราวผู้ใช้ทั่วไป?
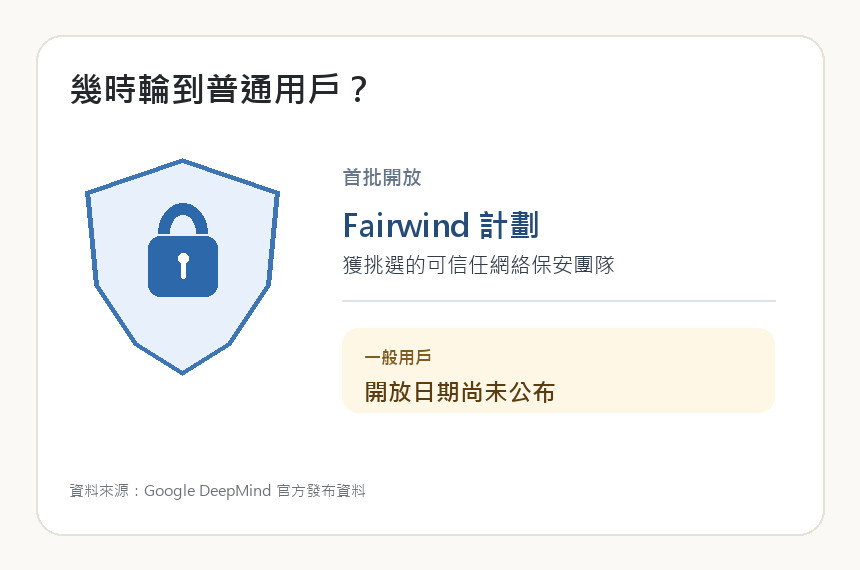
ปัจจุบัน Argon ถูกปล่อยให้ใช้งานในวงจำกัดผ่านโครงการ Fairwind แก่ทีมความปลอดภัยไซเบอร์ที่ได้รับคัดเลือกก่อน Google ระบุว่าจะขยายการเข้าถึงไปยังลูกค้า API แบบชำระเงินและผู้สมัครสมาชิก Google AI Ultra ในภายหลัง แต่ยังไม่ระบุวันที่แน่นอนสำหรับผู้ใช้ทั่วไป กล่าวคือ โมเดลอาจเปิดตัวแล้ว แต่ปุ่มให้ผู้ใช้ทั่วไป “ลองเลย” ยังไม่มา
Google ระบุราคาพื้นฐานของ API ในช่วงแรกเป็นหน่วยดอลลาร์สหรัฐคือ: 2 ดอลลาร์สหรัฐต่อหนึ่งล้าน Input Token และ 10 ดอลลาร์สหรัฐต่อหนึ่งล้าน Output Token; หลังช่วงโปรโมชั่นจะเป็น 4 ดอลลาร์และ 20 ดอลลาร์ตามลำดับ โดยแปลงเป็นเงินบาทตามอัตราที่กำหนด จะเป็นประมาณ 67 บาท (ราคาเดิม 2 USD) ต่อหนึ่งล้าน Input Token และ 336 บาท (ราคาเดิม 10 USD) ต่อหนึ่งล้าน Output Token; หลังโปรโมชั่นจะประมาณ 134 บาท (ราคาเดิม 4 USD) และ 672 บาท (ราคาเดิม 20 USD) โดย Google ยังไม่ได้แจ้งว่าช่วงโปรโมชั่นจะสิ้นสุดเมื่อใด ราคาถูกประกาศออกมาก่อนการเปิดให้ผู้ใช้ทั่วไปใช้งานจริง
ตารางเปรียบเทียบ 19 การทดสอบตาม Google
ด้านล่างเป็นการสรุปตามแผนภูมิอย่างเป็นทางการของ Google DeepMind โดยสีพื้นเขียวหมายถึงคะแนนสูงสุดในตารางนั้นๆ (ไม่ใช่สัญลักษณ์เฉพาะสำหรับ Argon) และคำว่า “ไม่ระบุ” หมายถึงในตารางต้นทางไม่มีตัวเลขของโมเดลนั้นๆ แต่ละการทดสอบวัดความสามารถต่างกัน จึงไม่ควรนำคะแนนข้ามรายการไปเปรียบเทียบกันโดยตรง
| 範疇 | 測試項目 | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|---|
| 專業工作 | Vals Index | 68.9% | 63.1% | 65.8% | 67.0% |
| 專業工作 | AutomationBench(分數) | 51.3% | 41.4% | 31.4% | 42.5% |
| 專業工作 | Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% |
| 專業工作 | Harvey’s Legal Agent Benchmark | 19.6% | 5.4% | 6.7% | 3.8% |
| 程式開發 | DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% |
| 程式開發 | FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% |
| 程式開發 | Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% |
| 程式開發 | Terminal-bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% |
| 機器學習工程 | PostTrainBench | 45.3% | 44.3% | 40.2% | 49.3% |
| 科學及數學 | Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% | 63.3% |
| 科學及數學 | LABBench 2 | 88.8% | 85.4% | 68.6% | 73.1% |
| 科學及數學 | RiemannBench | 76.0% | 72.0% | 65.6% | 69.6% |
| 長篇內容理解 | GraphWalks(最多 12.8 萬 Token) | 99.7% | 98.7% | 91.4% | 90.6% |
| 長篇內容理解 | GraphWalks(25.6 萬至 100 萬 Token) | 84.2% | 71.8% | 65.0% | 66.8% |
| 電腦操作 | Agent’s Last Exam(通過率) | 39.5% | 34.2% | 未列出 | 38.2% |
| 電腦操作 | OSWorld-2.0(離線測試部分得分) | 69.2% | 72.6% | 未列出 | 未列出 |
| 圖像及影片理解 | Chartography | 71.6% | 71.0% | 46.2% | 66.3% |
| 圖像及影片理解 | LVBench | 91.7% | 87.5% | 79.7% | 83.7% |
| 網絡保安 | CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% |
หมายเหตุ: ข้อมูลข้างต้นสรุปจากการเปรียบเทียบ 19 รายการที่ Google DeepMind เผยแพร่; ผลคะแนนบางรายการเป็นการคำนวณของ Google เอง ขณะที่ผลของโมเดลอื่นอาจนำมาจากตารางคะแนนสาธารณะหรือข้อมูลจากผู้ให้บริการ การตั้งค่าการทดสอบในแต่ละรายการอาจต่างกัน ดูรายละเอียดเพิ่มเติมได้ที่คำอธิบายการทดสอบอย่างเป็นทางการ